


 国产GPU筑基AI4S|摩尔线程打通Protenix-v2全链路,加速生命科学与药物研发
近日,摩尔线程基于自主MUSA软件栈,在训推一体智算卡MTT S5000上,正式完成了 开源生物分子结构预测模型Protenix-v2的全链路推理支持 。实测显示,S5000端到端推理性能较国际主流GPU平均提速约26%,且三维构象预测精度高度对齐。
Protenix-v2由字节跳动Seed团队研发,于2026年4月正式发布。作为 在多项核心基准测试中性能持平甚至超越DeepMind AlphaFold 3的全开源模型 ,它打破了海外顶尖模型权重不完全开放、无法私有化部署的限制,是 目前全球少数能够对蛋白质、DNA、RNA及小分子配体复合物进行高精度端到端预测的开源基座 。
此次在S5000上的完整适配,不仅攻克了高难度多分子复合物计算 在国产算力上的落地瓶颈,也形成一套性能更具优势****的全链路自主方案 。至此,摩尔线程已实现大分子结构预测、全基因组序列建模与临床医学影像三大AI for Science(AI4S)核心场景的端到端工程验证,为国内药企及科研机构提供自主可控且性能卓越的AI4S算力底座。
国产算力打通“最后一公里” ,赋能创新药物研发
蛋白质结构预测是生命科学研究和新药研发的关键底座, AI驱动的结构预测已成为全球科研竞争和产业应用的战略高地 。同时,生命科学涉及大量生物遗传敏感数据,对算力安全、数据合规等提出极高要求。
Protenix模型是首个在相同训练数据截止时间、模型规模和推理算力预算下, 性能超越AlphaFold3的全开源模型 。Protenix‑v2能实现多类型生物分子复合物端到端预测,为国内科研人员提供了可二次开发的高质量开源模型。但此前Protenix‑v2主要面向CUDA生态,国产算力缺少完整可用的落地方案,制约了国产化科研工作流落地。
摩尔线程此次打通的,正是Protenix-v2在国产算力上应用的“最后一公里”。通过实现全链路国产化运行,国内科研团队可以摆脱对海外算力的依赖,在MTT S5000上完成蛋白质结构预测、靶点研究、蛋白质分子设计等科研工作,助力我国创新药物研发的快速发展。
攻克AI4S复杂计算,MTT S5000比肩国际主流GPU
针对Protenix‑v2复杂的PairFormer、扩散采样、MSA预处理等计算链路,摩尔线程技术团队基于MUSA软件栈完成算子兼容与性能调优,解决科学计算场景下数值稳定性、访存密集计算等技术难点, 贯通从MSA输入、模型前向推理到pLDDT/PAE结果后处理的完整业务链路 。
经验证,摩尔线程MTT S5000展现出扎实的工程性能。本次测试 选取12个代表性的蛋白质测试样本 ,采用BF16精度, 完整保留MSA处理、模型推理、后处理全流程 ,将S5000与国际主流GPU进行性能、精度对标验证。以下统计均采用完整model-forward时间,确保测试结果能够反映实际推理效率。
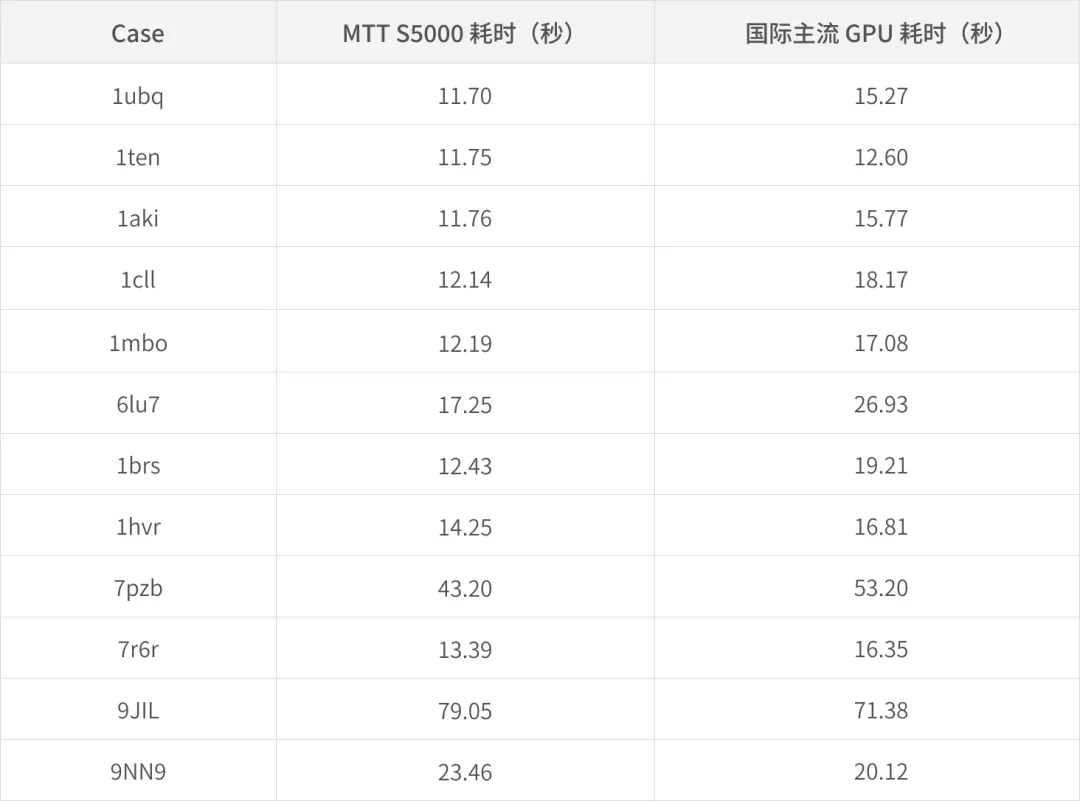
▲ 推理性能对比:在12个蛋白质结构预测案例中,MTT S5000在端到端推理耗时上展现出显著优势,其中10个样本的推理速度超越国际主流GPU,平均提速约26%
实测结果显示,MTT S5000预测精度与国际主流GPU整体偏差控制在合理浮点漂移区间, 蛋白三维构象结构评估指标高度对齐;多个样本端到端推理耗时优于对比国际主流GPU。
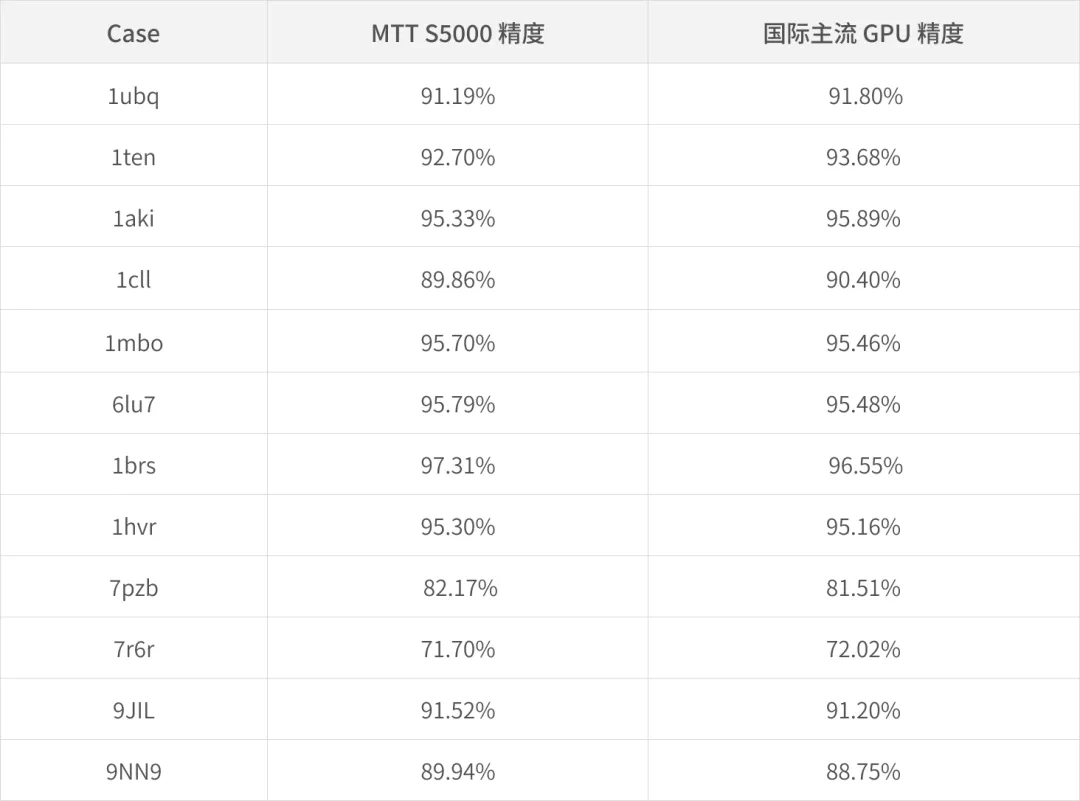
▲ 预测精度对比:MTT S5000与国际主流GPU在12个样本的综合平均预测精度高度吻合,其中7个样本精度微幅反超,单样本最大差异控制在约1个百分点内,蛋白三维构象结构评估指标对齐,构象生物学等价
为降低开发者使用门槛,摩尔线程同步上线 面向科研场景深度调优的Protenix-v2优化版Docker镜像 (驱动版本5.2.0),科研用户无需复杂环境编译,拉取镜像即可一键复现全套测试流程,快速开展蛋白质结构预测、分子辅助设计等科研工作。
来自北京大学/昌平实验室的曹云龙-简繁冲团队,根据科研任务场景独立测试了该优化版Protenix-v2,证实其相比在MTT S5000上直接开箱推理,推理速度提升100%以上,整体性能、精度与国际主流GPU相当。
▼Protenix-v2优化版Docker镜像:
registry.mthreads.com/public/protenix_v2:musa
覆盖三大核心场景,筑牢AI4S自主底座
目前,摩尔线程已经完成Protenix系列、Evo2基因组模型、MONAI医学影像框架等生命科学领域主流工具链适配, 覆盖蛋白质预测、基因组分析、医学影像三大AI4S核心场景 ,并构建起“前沿模型快速适配—性能深度调优—算法精度严格对齐—开箱即用镜像交付”国产化技术全链条。
摩尔线程将持续丰富生命科学AI生态,为AI4S领域提供更强劲的国产算力支撑。
*以上测试数据来自摩尔线程实验室及合作伙伴实测。
▼关于摩尔线程
摩尔线程以全功能GPU为核心,致力于向全球提供加速计算的基础设施和一站式解决方案,为各行各业的数智化转型提供强大的AI计算支持。
我们的目标是成为具备国际竞争力的GPU领军企业,为融合人工智能和数字孪生的数智世界打造先进的加速计算平台。我们的愿景是为美好世界加速。
-
gpu
+关注
关注
28文章
5612浏览量
138173 -
AI
+关注
关注
93文章
46814浏览量
308221 -
摩尔线程
+关注
关注
2文章
339浏览量
6972
发布评论请先 登录
中科曙光以超智融合推动AI4S创新发展
直击AI4S算力难题!中科曙光全链路解决方案亮相2026科学智能大会
华为昇腾AI4S助力科学计算模型应用创新
摩尔线程发布MusaCoder:首个基于国产GPU全栈训练的开源代码大模型
摩尔线程MusaCoder开源:首个基于国产全功能GPU全栈训练的代码大模型,性能比肩国际SOTA
摩尔线程 × 中科院计算所丨DeferredGS全栈国产化适配落地
摩尔线程完成DeepSeek-V4全链路工程化适配:S5000基于MUSA+SGLang实现复杂MoE模型快速落地
筑基AI4S:摩尔线程全功能GPU加速中国生命科学自主生态
中科曙光6万卡AI4S计算集群:用 "超智融合" 重塑科学计算叙事
摩尔线程 × 五一视界|共建全栈国产化的物理AI仿真体系

Day-0支持|摩尔线程MTT S5000率先完成对GLM-5的适配
全栈国产AI Coding上线:摩尔线程+硅基流动+智谱,强强联合!
摩尔线程正式推出AI Coding Plan智能编程服务
生命科学领先企业采用 NVIDIA BioNeMo 平台加速 AI 驱动的药物研发


评论