


 存储前沿洞察①|大模型推理Token经济性发展诉求,推动AI系统存储分层体系创新
9月15日,工业和信息化部、国家发展改革委印发《电子信息制造业发展“十五五”规划》,提出加快发展先进存力,推动“以存强算、以存代算”,完善分级分层数据存储架构,并突破智能分层存储、键值缓存等关键技术,研发相关新型存储产品。
围绕AI时代前沿存储技术,聚焦存储架构、新型介质、接口协议、核心芯片及产业化实践,德明利《前沿技术创新》专栏正式上线。首期内容由公司副总经理、研发中心总经理兼CTO范云松撰稿。范云松深耕存储主控芯片研发20余年,曾长期任职于华为及华为海思,担任企业级SSD研发团队核心主管。本期将结合其技术研发与产业实践,围绕AI推理时代的存储分层演进及新型存储机会展开分享。
随着AI大模型从训练走向推理和规模化应用,AI系统建设正经历从"以模型为中心"到“以Token经济性为核心”的逐步演变,围绕Token经济性,AI基础设施已经开始全栈重构,效率重心也在发生变化。
随着大模型参数规模来到万亿级别,超长上下文、长程Agent和多工具调用逐渐成为新模型的重要能力。行业衡量推理效率,也不再只看峰值算力,而是进一步关注首Token时延、Token生成速度、并发吞吐以及单位Token成本。
当推理竞争进一步落到速度、吞吐与成本上,数据如何承载,数据的缓存和分层也开始直接影响Token的产生效率,为存储产业发展带来新的机会窗口。
大模型上下文规模的发展,大致经历了从“单页文本”到“整本书”,再到“百万级文档”的跃迁,其整体节奏并非匀速发展,23年到25年期间,头部模型的上下文窗口从约十万Token快速扩展到千万Token级别,扩容幅度接近两个数量级,增长曲线相当陡峭。
23年Anthropic的Claude模型实现了10万个Token上下文。24年Google Gemini 1.5 Pro支持100万个Token。25年Meta宣布推出LLAMA 4 Scout,其上下文窗口达到了创纪录的1000万个。26年8月正式发布的DeepSeek V4-Pro,进一步将百万Token上下文能力作为标配。
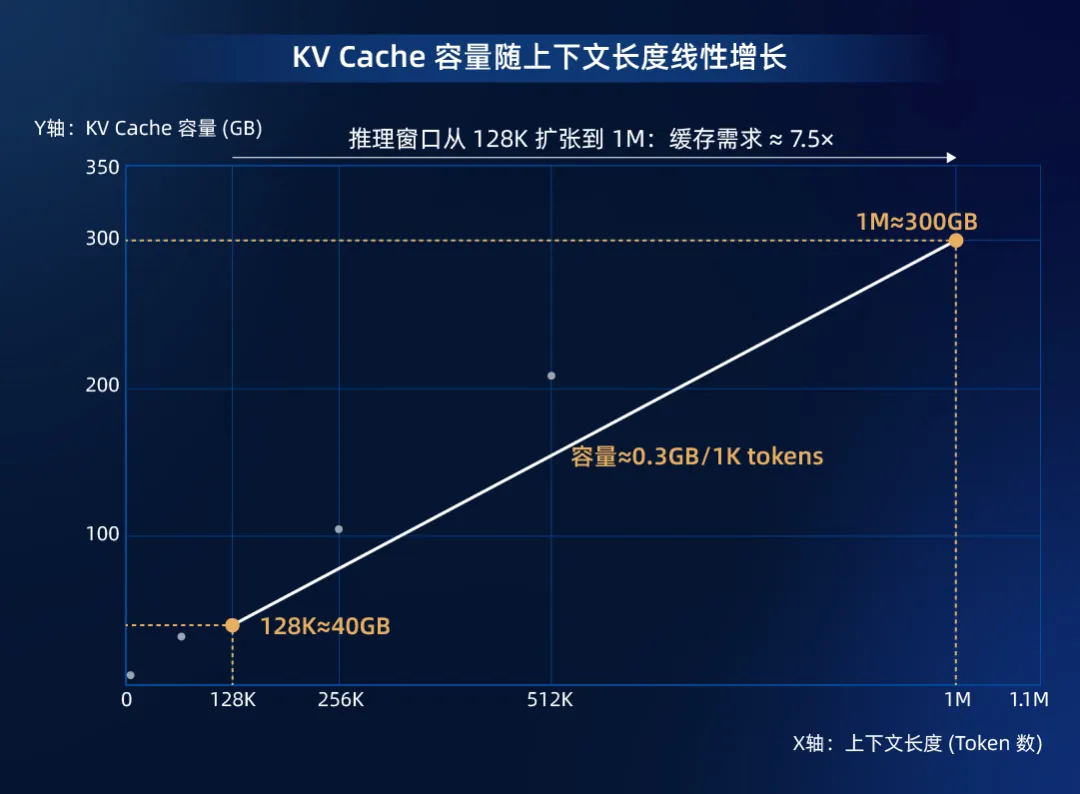
以传统70B级Transformer/GQA模型为例, 生成过程中每个历史Token的Key和Value都会按层保存在KV Cache里,所以上下文越长,KV Cache基本按Token数量线性增长,128K上下文约需40GB KV Cache,1M Token则接近300GB。超长上下文对内存容量的需求大大提高。
大模型的演进,当前同时还在经历从超长上下文进一步走向长程Agent和规模化推理的快速发展。Kimi K3、Qwen3.8-Max强调长程任务的自主规划、持续执行与闭环迭代,GLM-5.3也将长程任务作为重要方向。
以新发布的Kimi K3为例, 采用3:1的KDA线性注意力与Gated MLA混合架构,专门针对Prefix Cache进行推理优化,以降低百万Token长上下文的计算与缓存开销。但AI Coding场景等长程任务,进一步拉长了数据生命周期。相比传统“一问一答”,Agentic Coding场景需要在任务规划、模型推理、工具调用、结果返回和继续执行之间反复循环,上下文、中间结果和缓存数据需要在更长时间内保持可访问,对大容量内存以及闪存的需求将持续保持高位。
大模型推理的发展趋势
Agent推理代表着大模型推理的发展趋势,呈现出如下特征:高并发、长上下文、长程任务、强Cache依赖、成本敏感。行业也开始通过分层缓存和KV Cache卸载,将上下文、中间结果、缓存数据从HBM显存转移到更大容量的二层和三层存储层级。
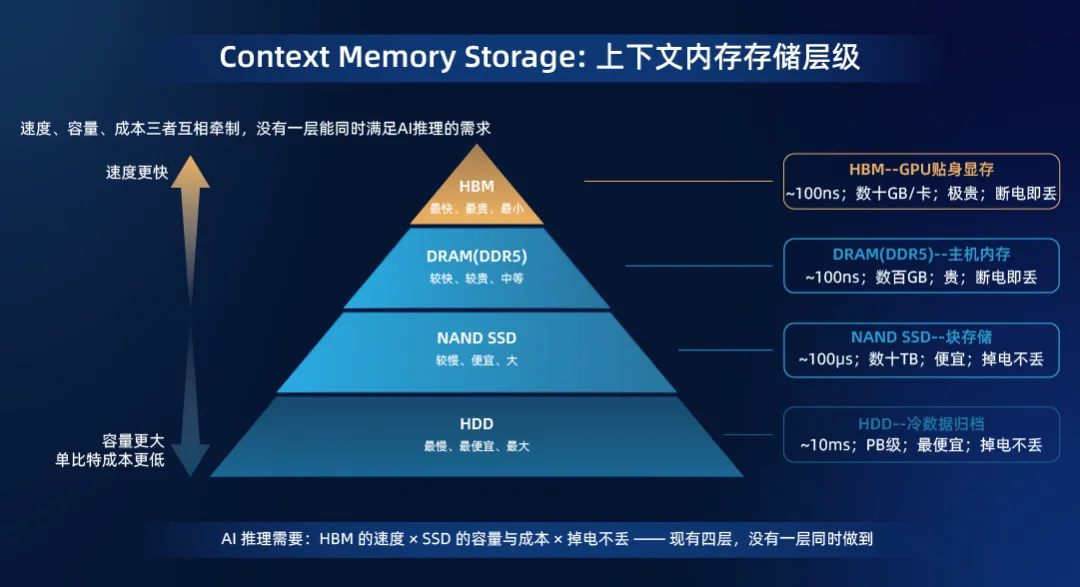
当前AI推理的数据主要由HBM、DRAM和NAND分层承载,随着KV Cache持续增长,AI推理开始面对三个问题:
问题1:容量墙
HBM带宽高但容量有限,DRAM的单Die容量提升也已接近极限,HBM/DRAM的扩容受系统功耗和空间的约束,方案相对复杂,在显存/内存容量相对有限的情况下,系统只有降低并发或缩短上下文以保障Token的产生效率,由此将牺牲吞吐效率与模型体验。
问题2:成本墙
内存整体供应当前处于紧张局面,供需失衡导致HBM和大容量DRAM采购成本持续保持高位,而大模型的迭代发展和推理应用的广泛普及,内存容量需求持续增长,导致AI数据中心大模型推理的部署成本持续推高。
问题3:持久化问题
HBM和DRAM均为易失性存储,断电或故障后数据无法保留,超长上下文和长程任务等复杂应用场景下,KV Cache需要采用持久化存储,以避免失效后重新计算,目前通常采用SSD作为KV cache 卸载的分层存储,但SSD的磨损寿命和小IO的传输性能存在瓶颈。
AI推理应用需要一个
兼顾容量、时延、成本与持久化的新层级
DRAM容量与成本受限,而采用NAND介质的 SSD虽具备容量和成本优势,但时延上明显高于内存,磨损寿命也存在差距,二者之间存在新的数据承载空档。
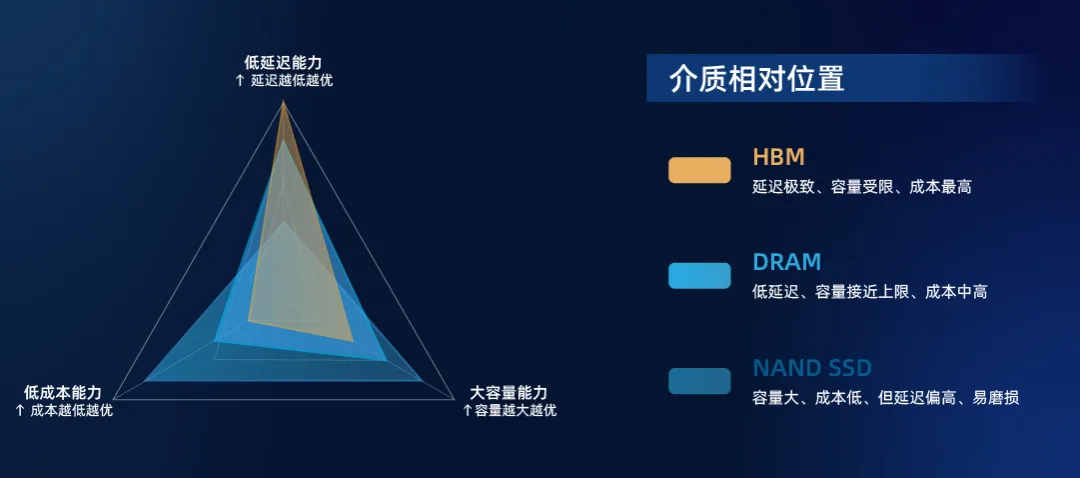
AI推理应用需要一个兼顾容量、时延、成本与持久化的新层级。

伴随KV Cache的不断膨胀与HBM/DRAM的容量和成本瓶颈,催生出新的存储层级G2.5层和G3.5层。
G2.5层
G2.5层采用内存语义 ,核心思路是通过CXL交换机构建一个解耦的、软件可编排的内存池,在延迟和容量之间取得平衡。以"近内存的低延迟访问"与容量优势得到行业的广泛关注。
基于CXL池化内存的硬件架构 :通过CPU进行整体管理,物理链路通常采用PCIe Gen5/Gen6,通过CXL交换机进行扩展,设备侧通过CXL控制器接入内存介质或新型存储介质。CPU通过CXL.mem协议以原生的Load/Store指令直接读写,对应用呈现为统一、无分层的地址空间,无需页面换入换出。访问延迟介于本地DDR与NVMe SSD之间,接近DRAM水平,但容量和成本效益显著优于纯DRAM方案。
G3.5层
G3.5层采用存储语义,核心思路是通过高速网络扩展,采用SSD对KV缓存进行持久化存储。 NVIDIA的CMX(Context Memory Storage)平台是这一架构的代表,其思路是将企业级 NVMe SSD组织为专用的KV缓存存储层,承接从HBM/DRAM外溢的上下文数据。通过CPU进行整体管理,采用以太网(Spectrum-X)提供RDMA网络,实现超节点内低延迟、高带宽的缓存访问,采DPU(BlueField)管理NVMe SSD并卸载KV缓存。相比传统存储方法,吞吐量与能效最高提升5倍, SSD单位容量成本显著低于GPU内存,适用于大容量长期上下文的存储。
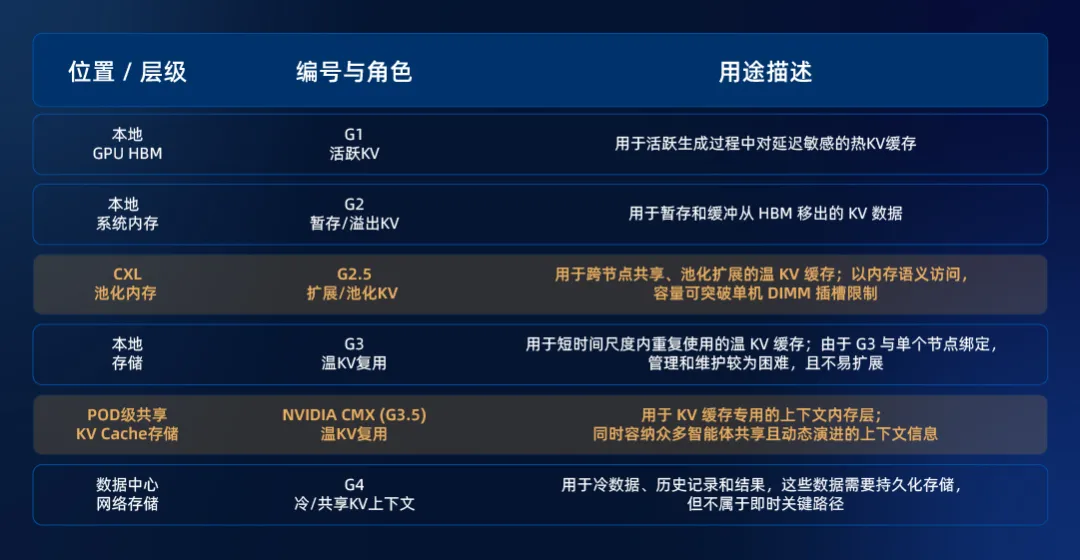
两条路径的硬件架构
两条路径的硬件架构共同指向一个趋势: AI基础设施的存储分层正在“变厚”,在GPU显存与传统存储之间,CXL内存语义路径构成了G2.5层,SSD存储语义路径则常被定位为G3.5 层;二者共同插入了一个由专用芯片(DPU/CXL 控制器)管理、由高速网络连接、介质选择服从于成本与延迟平衡的新硬件层。
针对G2.5层存储,德明利选择基于内存语义的技术路线,通过CXL扩展提供池化内存解决方案。
基于CXL的池化内存解决方案的优势
原生访问
支持基于CXL.mem协议的Load/Store原生访问。
生态成熟
针对CXL的支持,Linux已经迭代了多个内核版本,具备生产系统部署条件。
时延稳定
基于CXL交换机和CXL设备控制器的设计,时延接近本地DRAM。
平滑扩展
支持内存容量和带宽的平滑扩展。
内存池化
支持内存池化,消除"内存孤岛",优化TCO。
多介质支持
CXL方案可以同时支持DDR与持久化内存介质,支持业务弹性部署。
CXL内存池化路径更适合热KV Cache场景
以上六点决定了CXL内存池化路径更适合对延迟敏感、需要频繁随机访问的热KV Cache场景。
Load/Store语义让上层应用无需修改编程模型即可使用扩展内存;Linux内核的成熟支持意味着可快速对接现有云原生调度体系;接近DRAM的时延可保障Token生成速度不出现断崖式下降;容量与带宽的平滑扩展则为多卡、多机、多租户共享内存池提供了工程可行性;
CXL池化把内存从单机解耦为共享资源池,按业务实时按需分配、提升整体内存利用率、从而在同等算力下减少总内存采购量,直接降低 CAPEX 与功耗 TCO;
而CXL.mem的内存语义不仅覆盖易失 DRAM,也原生支持持久内存,可实现断电不丢数据,既解决内存容量墙,又补上本地SSD与 DRAM之间的性能断层。
围绕这一方向,德明利依托企业级存储核心芯片、固件算法和系统验证能力,推进CXL内存池化方案研发和部署。
从百万Token到长程Agent
AI推理正在重塑数据承载与分层方式
也为新型存储打开新的应用空间
德明利将围绕CXL内存池化技术路线
基于DDR和PCM新型存储介质的应用
持续推进核心芯片与产品化布局
为国产AI基础设施提供更具性价比的解决方案
-
存储
+关注
关注
13文章
5269浏览量
92165 -
AI
+关注
关注
93文章
46814浏览量
308215 -
大模型
+关注
关注
2文章
4446浏览量
6015
发布评论请先 登录
信而泰×DeepSeek:AI推理引擎驱动网络智能诊断迈向 “自愈”时代
【书籍评测活动NO.64】AI芯片,从过去走向未来:《AI芯片:科技探索与AGI愿景》
AI Ceph 分布式存储教程资料大模型学习资料2026
软通动力\"北京壹号词元工厂\"正式启动,发布开源词元(Token)工厂性能基准
2026年全球AI推理引擎产业分析报告
摩托车动力经济性的计算机模拟及其传动系的优化
AI存储瓶颈破解之道,西部数据用前沿技术持续引领存储革命
AI推理的存储,看好SRAM?
数字化时代的存储变革:闪迪引领AI应用的数据支持
AI推理时代,闪迪HBF和3D Matrix Memory两大创新技术突破存储墙
中科曙光发布Token加速技术体系 让大模型少等待、快输出
从数据到 Token:Arm 解读边缘 AI 的计算与存储


评论