


 一颗“不跟随”的芯片:东方算芯DF1000与国产算力的换道超车
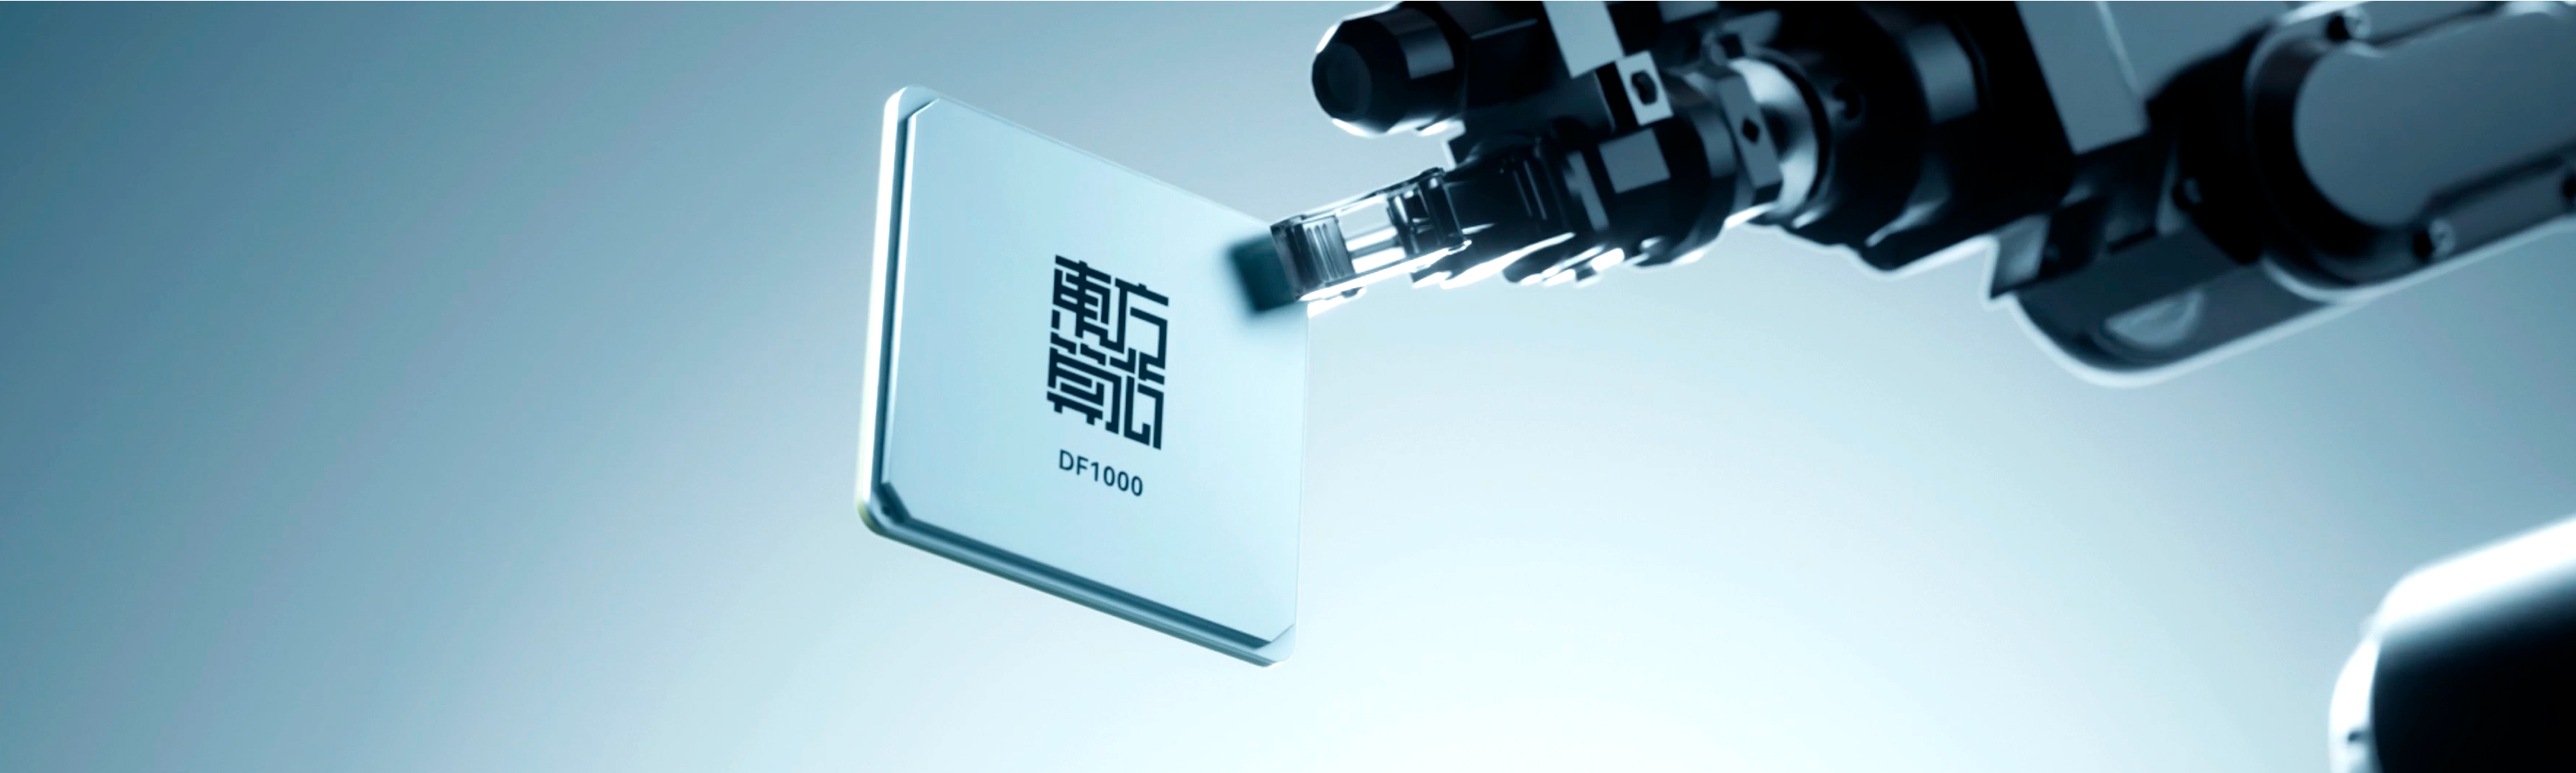
当国内绝大多数算力芯片创业公司还在GPGPU路线上追赶行业既定的产品迭代节奏时,东方算芯选择了一条几乎相反的路径:不依赖既有软件生态的路径锁定,不依赖先进制程,把清华大学近20年的可重构计算技术积累,投注在“软件定义可重构+3D堆叠近存计算”这条少有人走的路上。
这不是一次技术选型,而是一次战略突围。突围的是:当制程工艺的门被地缘政治关上一半、当HBM存储被海外厂商攥在手里,架构创新能不能成为国产算力的另一条出路。
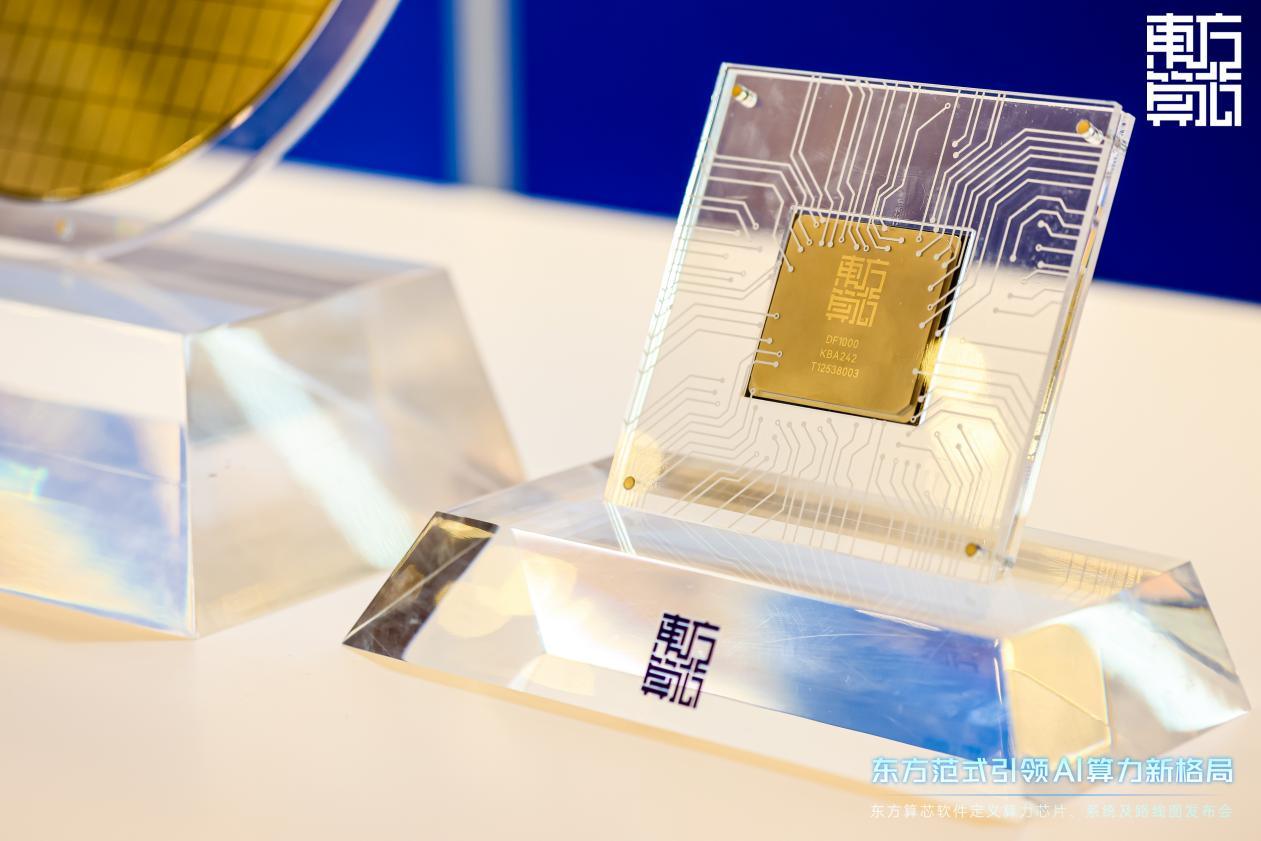
一年后,这场赌局有了第一个可以摆上台面的答案——DF1000系列软件定义近存计算3D AI芯片,以及覆盖单芯片到512卡集群的全维度产品矩阵。
一、跟随者的困境:为什么“对标追赶”正在遇到天花板
过去几年,国产AI算力芯片的主流打法是“对标追赶”——盯着行业头部厂商的产品路线图,在GPGPU路线上做迭代。这条路径曾经是理性的:生态兼容性强、开发者迁移成本低、市场教育成本几乎为零。但它建立在一个假设上——先进制程和HBM存储可以持续获取。这个假设正在从两端同时失效。
制程端
GPGPU架构对7nm及以下先进制程存在结构性依赖,而国内主流算力芯片企业已被列入实体清单,无法使用台积电、三星的先进制程代工;国内光刻设备供给不足,本土晶圆代工与国际顶尖水平存在代差,14nm及以上成熟制程成为国产芯片量产的主力工艺。换句话说,跟随者想跟随的那条路,本身正在变窄。
存储端
据中国信息通信研究院(CAICT)测算,截至2025年初,美国算力规模约为2400 EFLOPS,中国约为1053 EFLOPS——差距不只在芯片峰值算力,更在于访存带宽能否把峰值算力真正“喂饱”。HBM存储颗粒与2.5D/3D封装技术由海外企业主导,供给紧张、成本高企、断供风险始终悬在头上。多数国产芯片只能退而求其次适配普通DDR方案,结果是峰值算力参数好看,实际吞吐效率却被访存瓶颈死死摁住。
这还没算上硬件架构本身的问题:传统类GPGPU芯片一旦流片,硬件架构就固化了,只能靠软件层面“打补丁”式适配新算法。为了兼容多样化的AI模型,芯片不得不堆砌大量Tensor Core,结果是执行单一任务时大量计算核心闲置——买了一整个厨房的设备,但每道菜只用得上其中几件。
一句话总结:跟随式路线不是不能走,而是这条路正在因为它所依赖的两块基石——先进制程、HBM存储——同时松动而变得越来越窄。这正是架构创新型公司的窗口期。东方算芯是这批公司里,把“清华系可重构计算”这张牌打得较早、较系统的一家。
二、DF1000的技术逻辑:把“存不够”和“改不动”一起解决
东方算芯给出的方案,本质上是针对上面两个结构性问题,各开一把钥匙。
钥匙一:软件定义可重构架构,解决“硬件改不动”
传统芯片的调度以算子为核心,DF1000反其道而行,采用TensorTile作为核心调度单元,以数据块、任务块而非算子作为调度粒度,构建全异步、无阻塞的数据流执行引擎。
这个设计的价值不在参数本身,而在于它改变了芯片和算法之间的关系。传统架构下,算法迭代要等硬件下一代升级才能真正吃透;DF1000通过动态可重构多精度融合计算阵列,让芯片可以根据不同AI模型的运算特性,自动匹配最优的数据传输通路——“空间并行+时分复用”的调度模式,本质上是让同一批硬件资源在不同任务间灵活复用,而不是为每种可能性都预留一整套闲置产能。这也是DF1000试图对冲制程劣势的核心手段:用架构灵活性,换取14nm成熟制程下的有效算力密度。
钥匙二:3D混合键合近存计算,解决“存不够”
传统2.5D HBM封装依靠硅中介层和微凸点实现互联,互连间距在数十微米量级——这是物理结构给带宽上限设下的天花板。DF1000采用Hybrid Bonding无凸点垂直互连技术,把逻辑计算层和DRAM存储层垂直堆叠,将互连间距压缩到亚微米级别。经官方测试验证,DF1000访存带宽达6.4 TB/s,Scale-up互联带宽达900 GB/s。
如果用扩展路径的框架来理解这两个数字会更清楚:算力中心的扩展通常遵循Scale-in(芯片级向内集成)、Scale-up(单节点纵向扩展)、Scale-out(多机横向扩展)三条路径。6.4 TB/s的访存带宽对应的是Scale-in——它决定了单芯片能装下多大的模型、切分模型时会损耗多少通信开销;900 GB/s的Scale-up互联带宽,决定的是单节点内多芯片协同的效率上限。这两个数字不是同一件事的两种说法,而是分别卡住了“单芯片能力”和“集群协同能力”这两个不同的瓶颈位置。
三、放到全球坐标系里看:DF1000不是孤例,但选对了自己的战场
近存计算/存算一体本身并非东方算芯独创的概念。三星在HBM-PIM方向、SK海力士在AiM(Accelerator-in-Memory)方向均已布局多年,海外初创公司中d-Matrix专注于数字存内计算(DIMC)路线,也是这条赛道的代表性玩家。这意味着DF1000所在的赛道,是一条全球玩家都在下注、但尚未有绝对领跑者跑出规模化商用案例的赛道。
这对东方算芯既是机会,也是提醒。机会在于:赛道足够新,东方算芯有机会凭借清华系团队的技术积累建立先发认知;提醒在于:这条赛道的技术不确定性依然很高,3D堆叠的散热、良率、测试验证体系在全球范围内都没有形成统一标准——DF1000面对的不是“追赶别人已验证的路径”,而是和全球同行一起,共同把这条路径的工程化可行性趟出来。
四、商业化的真正考题:不是性能,是“迁移成本”
从商业竞争的角度看,AI芯片的竞争早就不是单一硬件层面的比拼,而是“芯片+软件+生态”的系统级竞争。以CUDA为代表的主流GPU软件生态,历经十余年积累已形成完整的加速库、调试优化工具、编译器及运行时体系,全球开发者对这套体系已经形成深度路径依赖。
DF1000选择脱离这一体系,采用自主软件架构,这意味着它无法直接复用现有主流生态下的算子库和模型代码。
尽管产品已经兼容PyTorch、Triton、Megatron-LM、vLLM、SGLang等主流AI开发与推理框架,企业用户仍然需要基于自研的TensorTile编程体系完成模型重构和算子优化——这中间的工作量,才是DF1000真正的商业化考题。相比国际巨头百万级的开发者生态,以及国内头部算力厂商多年积累的开发者社区、调试工具与迁移文档,东方算芯的软件生态仍处于起步阶段。这不是靠一次架构创新就能补齐的短板,而是需要时间和真实客户反馈持续喂养的过程。
也正因为如此,当前政企客户和数据中心在选型时,更倾向于生态成熟、落地案例丰富、稳定性经过大规模验证的产品——这不是DF1000技术不够好,而是“技术足够好”和“客户敢用”之间,永远隔着一段由真实案例堆出来的信任周期。DF1000目前仍处于样品验证和小规模试点阶段,这段信任周期,才是真正决定它能走多快的变量。
结语:架构换道,换的是长期主义的赛道
DF1000验证了一件事:在成熟制程条件下,通过架构原始创新和存储结构优化,确实可以摆脱对先进制程与海外HBM技术的依赖,实现高端算力的自主可控输出。这为国产算力产业突破海外技术体系封锁,提供了一条可行路径,具备重要的行业战略价值。
但芯片峰值算力参数从来只是起点。规模化商用考验的是稳定的工程化能力、可控的量产成本、完善的软件生态,以及经得起大规模验证的落地案例——这些恰恰是参数表上体现不出来,却是决定一颗芯片能不能真正走进数据中心机房的东西。
东方算芯选择了一条更难、但可能更有长期价值的路。这场“架构换道”的赌局,现在只走完了第一步——验证“可以做出来”。接下来更难的一步,是验证“可以规模化地、可持续地做下去”。这条路能走多远,答案不在参数表里,而在接下来一两年真实客户的复购率和产业链的协同速度里。
附:核心参数速览
| 核心参数 | 数值/说明 |
|---|---|
| 峰值算力(单芯片,BF16) | 520 TFLOPS |
| 访存带宽(Scale-in) | 6.4 TB/s(3D混合键合) |
| Scale-up互联带宽 | 900 GB/s |
| 制程 | 国产14nm成熟制程 |
| 封装工艺 | 晶圆级3D混合键合(Hyid Bonding) |
| 接口标准 | OAM 2.0 |
| 框架兼容 | PyTorch / Triton / Megatron-LM / vLLM / SGLang |
| 集群扩展上限 | 可平滑扩展至512卡 |
| 单节点算力(TY64-M,8卡) | 33 PFLOPS |
-
芯片
+关注
关注
464文章
56663浏览量
484757 -
AI
+关注
关注
93文章
46823浏览量
308226 -
算力
+关注
关注
2文章
2548浏览量
17516
发布评论请先 登录
近存算力时代来了!24个月跑通AI集群商用,详解东方算芯的3D大算力系统级创新
集聚算力设备与技术,2027甘肃绿色算力展会,兰州AI算力展
合见工软UCIe芯粒互联IP落地东方算芯 3D算力芯片实现规模商用
词元经济加速落地,海光双芯筑牢国产算力底座
换道超车:太初元碁发布T2Ultra芯片及超智融合计算系统,每百万Token推理成本缩减一半
东方算芯亮相WAIC 2026,聚焦国产大算力芯片与系统方案

兆芯携手东方算芯开启高端算力芯片全栈自主新范式
国内首颗软件定义近存计算AI芯片亮相,14nm成熟制程实现520万亿次算力
国产AI芯片给行业上了一课:未来拼的不是2nm,而是时间
用“东方范式”破局:东方算芯发布首款近存计算 3D AI算力芯片 DF1000
3D算力芯片风口正盛!东方算芯估值122亿,算苗科技成功流片
国产算力出海元年开启


评论