


 弥合带宽缺口,高性能AI推理如何受益于GDDR7?
作者:Rambus半导体IP产品管理总监Nidish Kamath
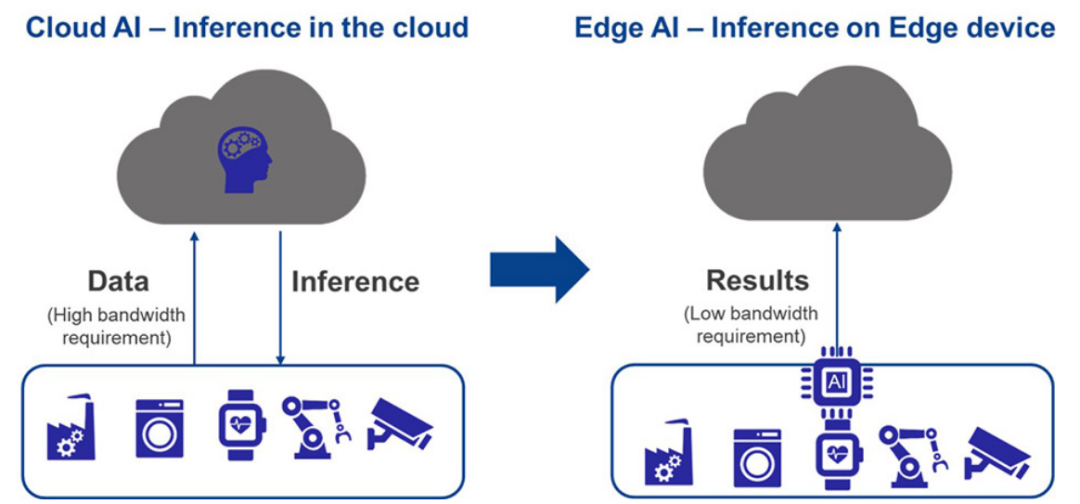
当前AI领域的发展格局正由大型语言模型(LLMs)的迅猛增长所主导。虽然云端对于这些超大规模模型的训练依然至关重要,但一个显著的转变正在发生:AI推理正从集中式数据中心向网络边缘和终端设备迁移。这一趋势涵盖了从5G基础设施到汽车、安防摄像头和手机等终端设备在内的广泛领域。
在数字化转型持续加速的高增长地区,这种迁移趋势尤为显著。根据IDC数据显示,2024年下半年,中国边缘云市场规模达到73.9亿元人民币。在边缘侧完成轻量化模型训练和AI推理已成为行业关注的焦点,正驱动这一细分市场实现快速增长。
边缘计算的优势显而易见。本地化数据处理能提供用户期待的实时响应。而最大限度的减少数据传输不仅能减轻网络负荷,还能通过敏感数据的本地化存储来提升安全性。随着先进处理单元广泛集成到日常设备中,我们正见证边缘应用的爆发式增长,其功能已远超基础任务范畴。如今这些应用涵盖语音识别、网络监控、天气预报,甚至机器人技术与AI医疗设备,也对边缘硬件的处理能力提出了更高且更严苛的要求。
不断演进的市场格局催生出具有不同内存需求的细分市场。云托管应用需要绝对最高级别的内存带宽,通常超过每秒1TB,传统上采用HBM和DDR技术提供支持。网络边缘(如5G基础设施)则需要在300-500 GB/s的高性能与成本效益之间寻求精妙平衡。终端设备则更注重成本控制,虽仅需50-100 GB/s的带宽,但对带宽增长的需求同样迫切。而这一贯穿所有细分领域的共同特征是:内存带宽的需求正在全面持续攀升。
然而,这一需求也暴露了现代系统设计中的一个关键弱点:处理能力与内存带宽之间正出现日益严重的脱节。在过去两年中,AI模型规模惊人地增长了410倍,而同期内存带宽仅提升约一倍。这种巨大反差导致显著的“内存鸿沟"——内存子系统正日益成为制约AI性能的瓶颈,限制了先进处理器的潜力发挥。
为此,业界正日益转向专用处理器以提升效率。尽管GPU依然表现强劲,但针对特定应用构建专用硬件,可以通过精确匹配处理器与内存的预期工作负载,来实现更高效的内存利用。另一种解决方案则超越了处理器本身,通过采用2.5D架构、3D堆叠或芯粒(Chiplets)等新兴技术,使整个系统获得卓越的处理能力。然而,尽管架构变革层出不穷,核心挑战依然存在:即如何选择一个既能平衡性能,又具备商业可行性的内存标准。
面对爆发式的边缘 AI 应用,选择合适的内存解决方案面临着艰难的"三难困境"。高带宽内存(HBM)虽能提供海量带宽,却伴随着高昂的系统成本和2.5D/3D堆叠设计的复杂性。低功耗双列直插内存(LPDDR)在标准封装中兼具能效与高容量优势,但单设备带宽较低。边缘AI系统正处于两难境地:它们需要在带宽、容量、成本和外形尺寸之间寻求平衡。
JEDEC GDDR7标准正是为解决这一特定挑战而量身打造。该标准实现了性能的巨大飞跃,将每比特带宽从GDDR6的24 Gbps提升至36 Gbps。这使得32位设备的总带宽达到144 GB/s。凭借规格中48 Gbps的上限,总带宽还能进一步提升。采用2-4个GDDR7设备的内存子系统,即可实现边缘AI目标带宽——300-500 GB/s。
这一性能飞跃得益于信号传输技术的根本性变革。GDDR7从传统的NRZ(2位)信号传输方式,升级为创新的PAM3(3位或三进制)信号传输技术。通过这一创新技术,结合两位专用纠错位,GDDR7控制器和物理层芯片能在与GDDR6相同的链路预算下实现更高数据速率。对于系统设计者而言,这不仅让性能升级变得更可控,也更具成本效益。
为直观展现这些技术指标的实际影响,我们可以考察一个真实的商业设计场景。假设一个典型的边缘AI应用目标是实现500 GB/s的内存带宽:若采用GDDR7,仅需四颗 32Gbps的封装即可达标。与LPDDR5X(速率为 9.6Gbps)相比,GDDR7占用的电路板面积更小;而与HBM4(速率为 8.0Gbps)相比,其总系统成本更低。在这个案例中,基于GDDR7的系统在LPDDR与HBM这两种设计方案之间找到了一个理想的平衡点。
与 GDDR6 的双通道设计相比,GDDR7 具备四个独立通道。这种设计提供了更细的执行颗粒度,对于 AI 推理应用至关重要,它能实现更灵活的数据组织方式,并显著提升整体系统效率。此外,该标准还整合了关键的RAS(可靠性、可用性、可维护性)特性,例如片上纠错码(On-die ECC),这对于构建稳健可靠的边缘部署至关重要。随着行业采用这一新标准,可靠的IP合作伙伴对于确保芯片的成功实现将变得至关重要。
作为在高性能内存和互连解决方案领域的领先企业,Rambus具备独特优势来应对这些挑战。Rambus GDDR7控制器IP支持JEDEC规定的全部标准特性,已在客户量产中通过高达40 Gbps的芯片验证。该方案同时具备全行(all-bank)和单行(per-bank)刷新模式以降低功耗。同时,该IP对x16及x8合盖模式(Clamshell mode)的支持,为边缘侧设备提供了更多样化的实现选择。
Rambus GDDR7控制器以软IP核形式交付,能够与第三方GDDR7物理层(PHY)实现无缝协作。该功能为客户提供了“开箱即用”的完整子系统,极大简化了SoC的集成工作。在向客户SoC团队交付过程中,Rambus会对每个客户的内存控制器配置及第三方物理层文件进行全面回归测试。此外,Rambus还提供专家级技术支持和定制化服务等增值方案,助力客户加速产品上市进程。
在人工智能和生成式AI时代,内存带宽缺口仍将是一个挑战。作为内存技术的行业先行者,Rambus将继续与行业合作伙伴紧密协作,提供关键的内存与互连技术,为从云端到边缘的AI产业进步注入强劲动力。
-
AI
+关注
关注
93文章
46832浏览量
308231
发布评论请先 登录
双青龙100TAI+V7 690T高性能AI只能处理平台-设计原理参考
2026年全球AI推理引擎产业分析报告
是德科技存储芯片测试解决方案概览
[资料] BK7259:集高性能计算、多协议无线、完整音视频处理和边缘AI推理于一体的综合性系统级解决方案SOC。
BK7259:集高性能计算、多协议无线、完整音视频处理和边缘AI推理于一体的综合性系统级解决方案SOC。
OPi AI Studio Pro 204G带宽、达芬奇架构与CANN软件栈全梳理
边缘AI硬件选型时最看重算力、内存带宽、还是生态成熟度?
NVIDIA RTX PRO 5000 Blackwell GPU多卡系统深度测评
直播预告|玄铁 x Canonical:从本地推理到 AI 工厂,基于 RISC-V 的 AI 基础设施创新路径探讨
如何在边缘AI应用场景中实现高性能、低功耗推理(上)
是德科技推出全新GDDR7发射端一致性测试解决方案
如何在边缘AI应用场景中实现高性能、低功耗推理(上)
新品 | AI Pyramid AI Pyramid-Pro,面向本地推理与智能交互的高性能AI PC

使用NORDIC AI的好处
昆仑芯R200 AI加速卡技术规格解析


评论